問い合わせメールを担当部署へ振り分けます。社内検索で役立つ資料を選びます。AIが作った回答を確認します。企業の仕事には、文章を書く前後に、こうした小さな判断が数多くあります。
TypeSafe AIの「Jev」は、その判断をソフトウェアに組み込むためのAIモデルです。何が新しく、どんな業務で役立つのでしょうか。中小企業の実務を念頭に、特徴と導入時の注意点を解説します。
※2026年10月15日更新:10月14日の公式発表を反映し、Jev 1.14と実験的な画像対応などを追記しました。価格の確認条件は該当箇所に記載しています。Jevの試用・性能の再現検証は行っていません。
生成AIによる説明用イラスト。Jevの実製品画面・実測結果ではありません。
Jevとは? 業務の中で「選ぶ・採点する・判定する」AI
Jevは、TypeSafe AIが「System One」と呼ぶモデル群の最初の公開モデルです。資料やメッセージなどの評価対象と質問を渡すと、プログラムで扱える形式の回答を返します。
基本的な判断の質問には三つの種類があります。Choiceは「請求・配送・製品相談」のような選択肢から一つを選ぶものです。Scoreは、あらかじめ定義した基準で緊急度や関連性を採点するものです。Noulは、「この文章は返金を求めているか」といった問いに、Yesである確率を返すものです。
Jevは会話文やコード、判断理由の文章を生成しません。既存システムの中に組み込む判断機能として捉えると、役割が分かりやすくなります。
出典:https://docs.typesafe.ai/concepts/system-one
何がすごいのか? 判断の結果と不確実さを使える
一つ目の特徴は、出力の扱いやすさです。担当部署の選択や評価値をそのままプログラムの分岐に使えるため、AIの文章を人が読み直して処理を決める工程を減らせます。
二つ目は、不確実なケースを別の処理へ回せることです。ChoiceとScoreには選択肢・評価段階ごとの確率とconfidenceという指標が付きます。判断が曖昧なら人に確認を求める、追加情報を集めるといった運用を設計できます。
ただし、confidenceは確率分布から計算される指標で、「0.9なら90%正しい」という意味ではありません。高い値でも誤判断は起こり得ます。自社のデータで確かめながら、どの結果を自動処理するか決める必要があります。
出典:https://docs.typesafe.ai/confidence
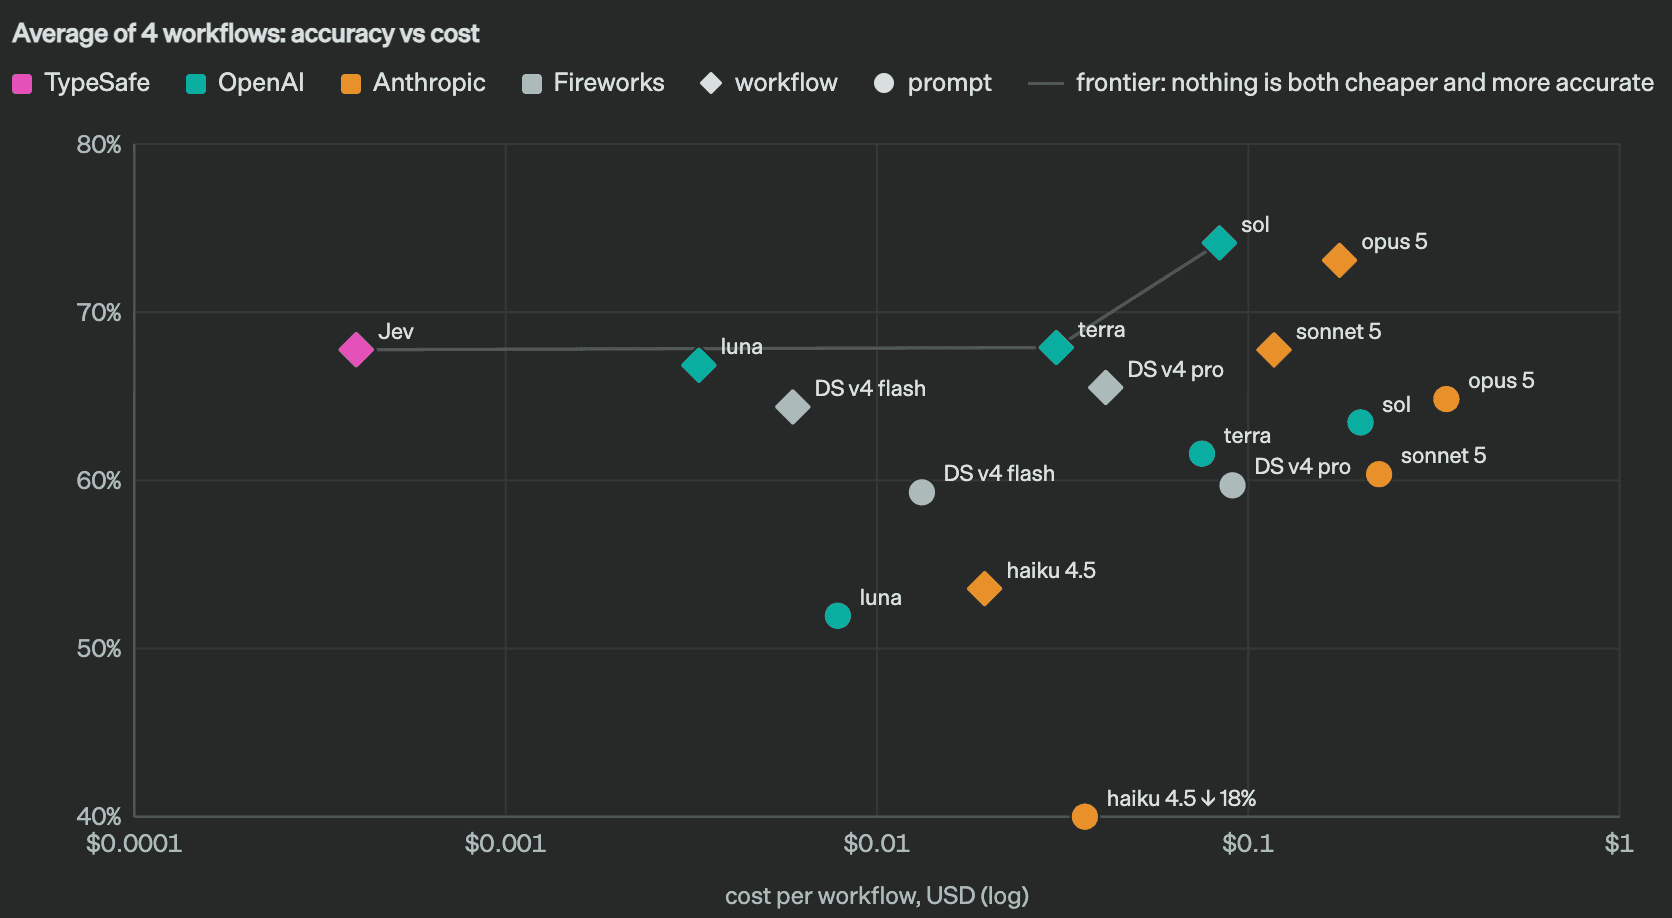
三つ目は、複数の質問を一度に評価する設計です。同じ問い合わせに対して、用件、緊急性、担当部署などを並列に判断できます。TypeSafeは、この処理方式と判断に向けた学習を、高速・低コスト化の要素として説明しています。
出典:https://typesafe.ai/blog/introducing-system-one-models-and-jev
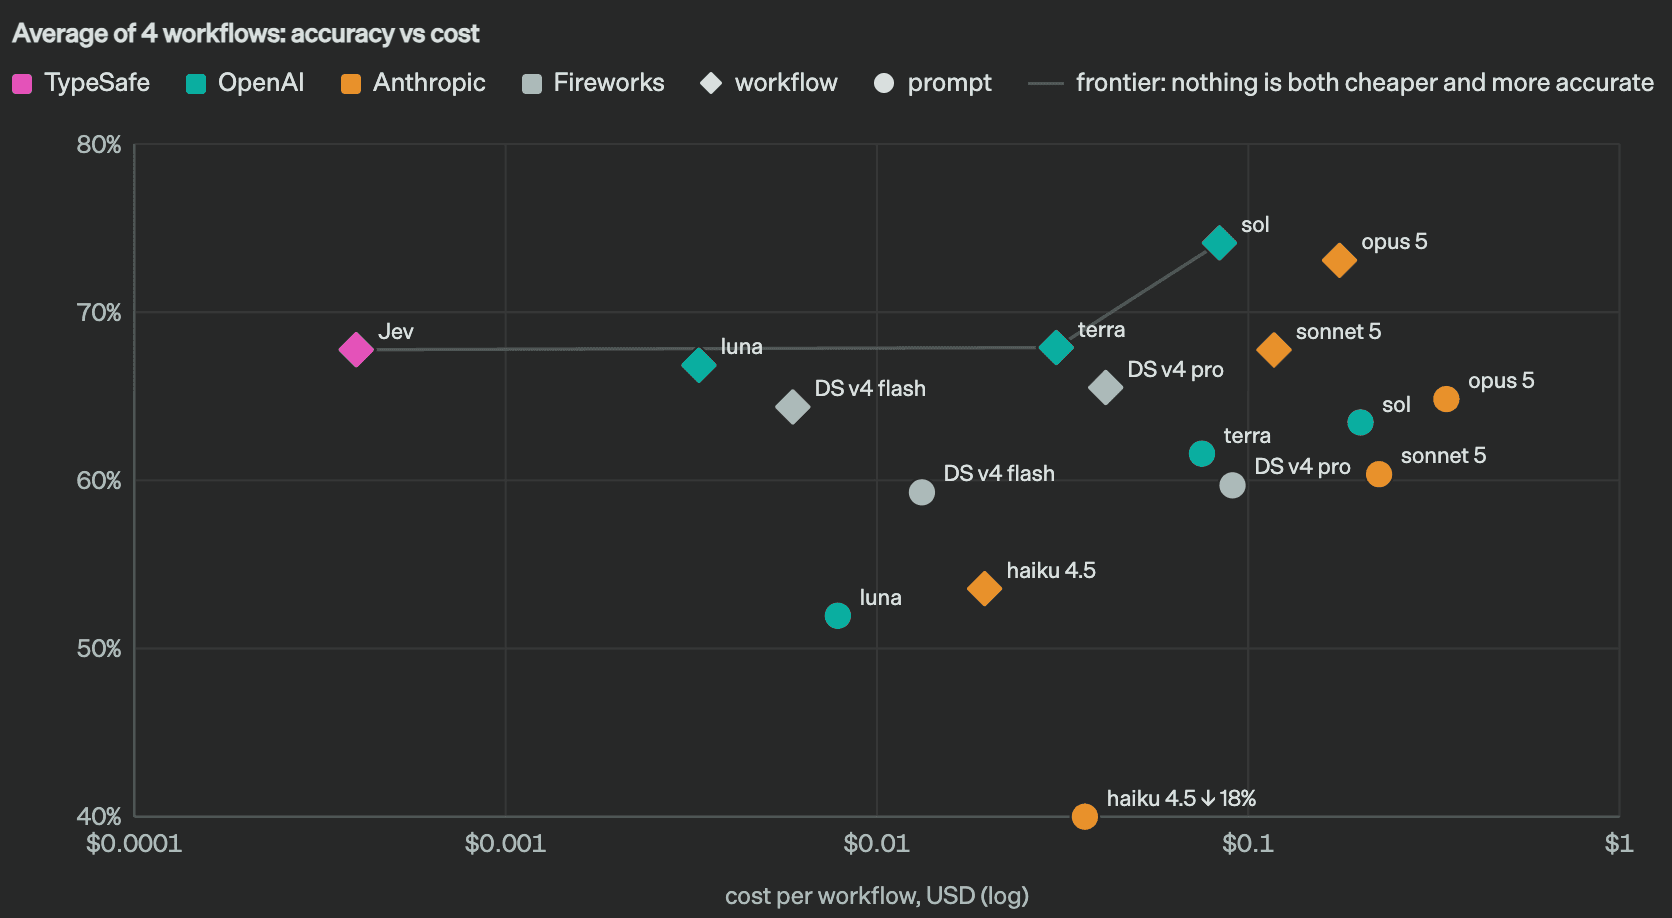
TypeSafe AIによる4種類のワークフローの自社評価。横軸は対数表示の実行コスト、縦軸は同社定義のaccuracyです。独立検証や全AI業務での性能保証を示すものではありません。
画像出典:TypeSafe AI公式記事
生成AIや従来の自動化と、どう使い分ける?
構造化した回答を返す機能は、Jevだけのものではありません。例えばOpenAIのStructured Outputsも、指定したJSON Schemaに沿う出力を提供しています。「既存のLLMでは形式を保証できない」という比較は正確ではありません。
出典:https://developers.openai.com/api/docs/guides/structured-outputs
Jevの特徴は、用途を絞った判断と確率を、ソフトウェア向けのインターフェースで返すことです。実務では、用件の分類をJev、返信文の作成を生成AI、金額計算や権限管理を通常のプログラムに任せる組み合わせが考えられます。
明確な条件式だけで処理できる業務なら、まず通常のプログラムで十分か検討しましょう。自然言語の意味を読む必要があり、選択肢や評価基準を定義できる部分が、Jevを検討する候補になります。
中小企業では、どこに使える?
例えば、問い合わせの一次仕分けです。メールを「納期確認・製品相談・請求・その他」に分類し、判断が曖昧なものを確認待ちにする運用が考えられます。例外を受け止める「その他」を用意しておくことも重要です。
社内検索では、検索で集めた文書が質問に関係しているかを評価し、回答作成に渡す資料を絞る使い方があります。また、AIが作った回答と根拠資料を照らし合わせ、特定の主張が資料に支えられているかを確認する用途も公式に紹介されています。
出典:https://docs.typesafe.ai/concepts/use-case-map
いずれも、導入効果が保証された業務ではありません。処理件数、現在の確認時間、誤りの影響を整理すると、試す価値を判断しやすくなります。
価格と導入事例は、条件と一緒に読む
2026年10月13日確認時点のJev 1.13の公表価格は、入力100万トークン当たり0.042米ドル、出力は無料です。この価格を1.14にそのまま適用せず、利用するモデルの最新料金を確認してください。ただし、これはモデル利用料です。システム開発、データの前処理、他のAI、人による確認の費用まで含めて評価する必要があります。
出典:https://docs.typesafe.ai/models
TypeSafeが2026年10月7日に公開したJack & Jillの事例では、候補者マッチングの初期評価をGemini 3.1 Flash LiteからJevへ変更し、費用を約88%削減したと報告しています。求人1件に対する候補者評価の処理時間も、中央値で20.3秒から10.3秒になったとされています。
出典:https://typesafe.ai/blog/jack-jill-jev-case-study
これは企業が公表した特定業務の比較結果です。同じ削減率をすべての業務に当てはめることはできません。また、採用に関わる利用では、評価基準の公平性を点検し、人がレビューできる運用が欠かせません。
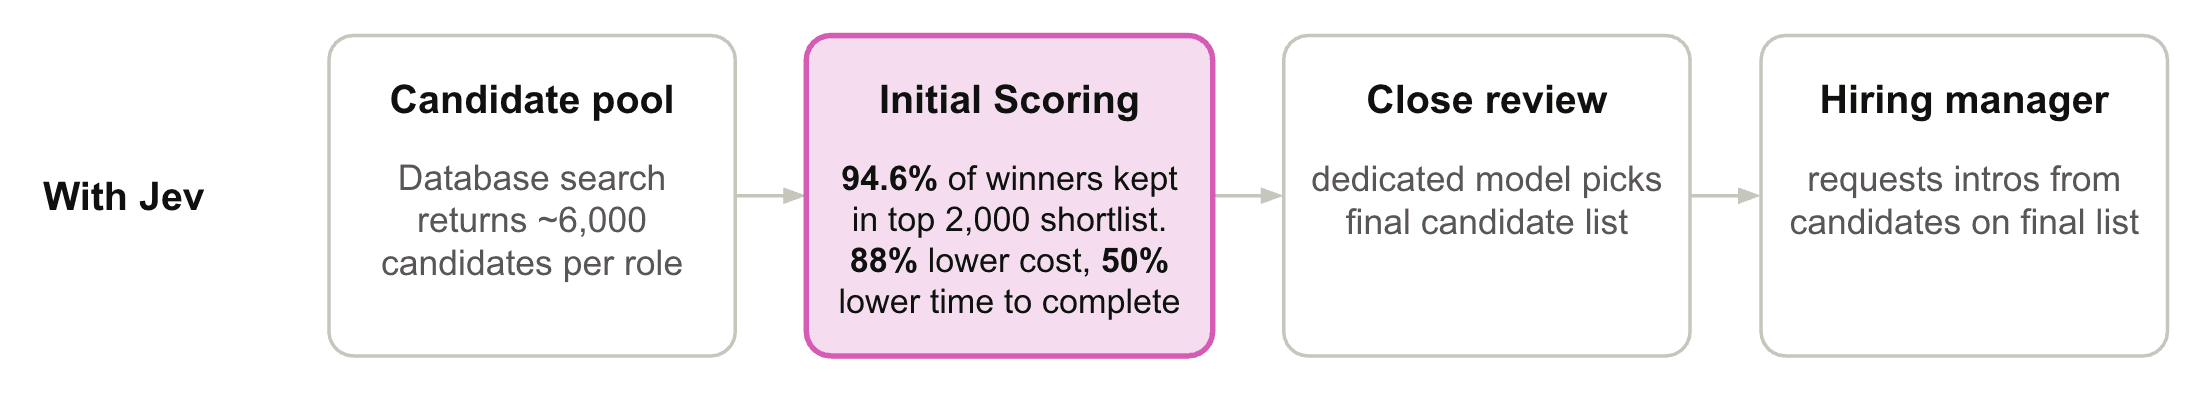
Jack & Jillの特定事例における初期スコアリングの導入図。図中の88%は当該処理のトークン費用、50%は中央値ベースの処理時間の比較です。採用成果や公平性の改善を保証するものではありません。
画像出典:TypeSafe AI公式記事
導入前に確認したい、日本語・誤判断・データ管理
10月14日の公式発表では、Jev 1.14.0をjev-previewとして提供しています。発表時点ではjev-latestを約1週間後に1.14.0へ切り替える予定で、1.13.0も引き続き利用可能としています。10月15日に確認した公式Modelsページの別名一覧では、jev-latestはjev-1.13.0、jev-previewはjev-1.14.0を指しています。将来の切り替え予定と、確認時点の記載を分けて捉えてください。
画像入力は、1.13.0でもDanger Zoneの実験機能として利用できます。新しいbox型は、単一のバウンディングボックスを返す型で、1.14.0のみが対象です。長いコンテキストも実験機能として開放されています。これらは本番利用の信頼性を保証するものではなく、通常のテキスト処理と同じ前提で導入しないことが大切です。
同社は1.14で多言語対応の改善を見込んでいますが、日本語の実務で十分な精度が得られるかは別の問題です。利用するバージョンと実験機能の有無をそろえ、自社の実データで確かめてください。
出典:https://docs.typesafe.ai/models
公式資料は、数え上げや日付比較、無関係な情報を多く含む入力、悪意ある指示が混じった文章などを苦手な例として挙げています。指定された形式で返ることと、内容が正しいことは区別しましょう。
出典:https://docs.typesafe.ai/model-jaggedness/jev-1.13
データについては、顧客入力をモデルの訓練や追加学習に使わないとしています。一方、保存しない仕組みであるZero Data Retentionは企業向けの提供です。顧客情報や社内文書を渡す前に、契約とデータの扱いを確認してください。出典:TypeSafeプライバシーポリシー / データの取り扱い
生成AIによる説明用イラスト。Jevの実製品画面・実測結果ではありません。
まずは、一つの判断を小さく試す
Jevを導入する際は、問い合わせの分類など、誤りを確認・修正しやすい業務から始めるのが現実的です。人の判断と並行して動かし、分類の精度、処理時間、確認が必要な割合、総費用を比べます。
大切なのは、AI単体の性能だけでなく、業務全体が改善するかです。Jevは、生成AIや既存システム、人の判断と組み合わせることで、繰り返し発生する小さな判断を効率化する選択肢になります。