ClearAI編集部|2026年10月30日
発表日:2026-10-28
NVIDIAは10月28日、音声モデル「Nemotron 3.5 Transcribe」と関連するデータ基盤「Granary v2」を紹介した。公開されたモデルは、録音から文字起こし、翻訳、話者を区別したテキストなどを生成する。会議や通話の録音を自社の環境で処理し、業務に合わせて出力を調整したい開発者に関係する発表だ。
提供状況:Hugging FaceとModelScopeでモデルを公開。商用・非商用利用に対応するOpenMDW-1.1ライセンス。録音音声向けでライブストリーミング用ではない。
一つのモデルで複数の音声処理
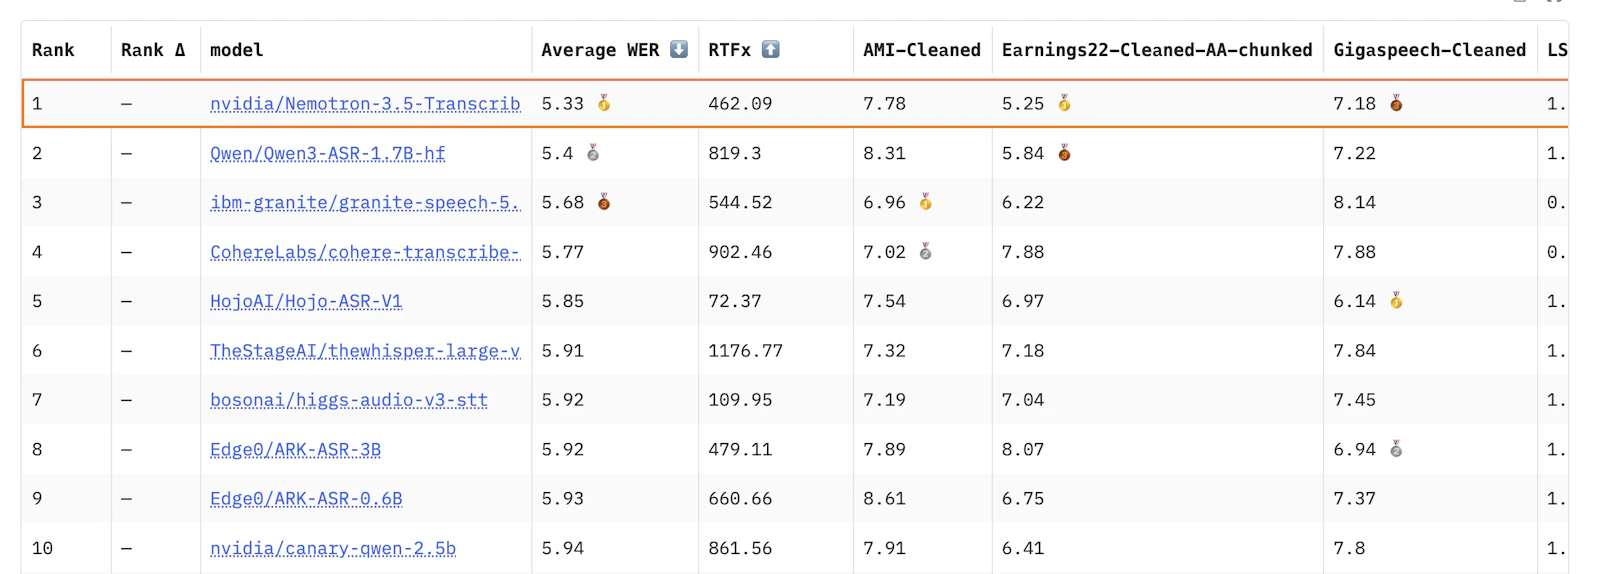
文字起こしは40言語、英語との双方向の翻訳は31言語、話者を識別した文字起こしは13言語に対応する。最大1時間の録音と最大8人の話者を扱えるとしている。ただし、対応言語は処理の種類によって異なる。音声に関する質問応答の学習言語は英語であり、すべての機能が40言語で同じように使えるわけではない。
公開モデルを自分の環境で動かす
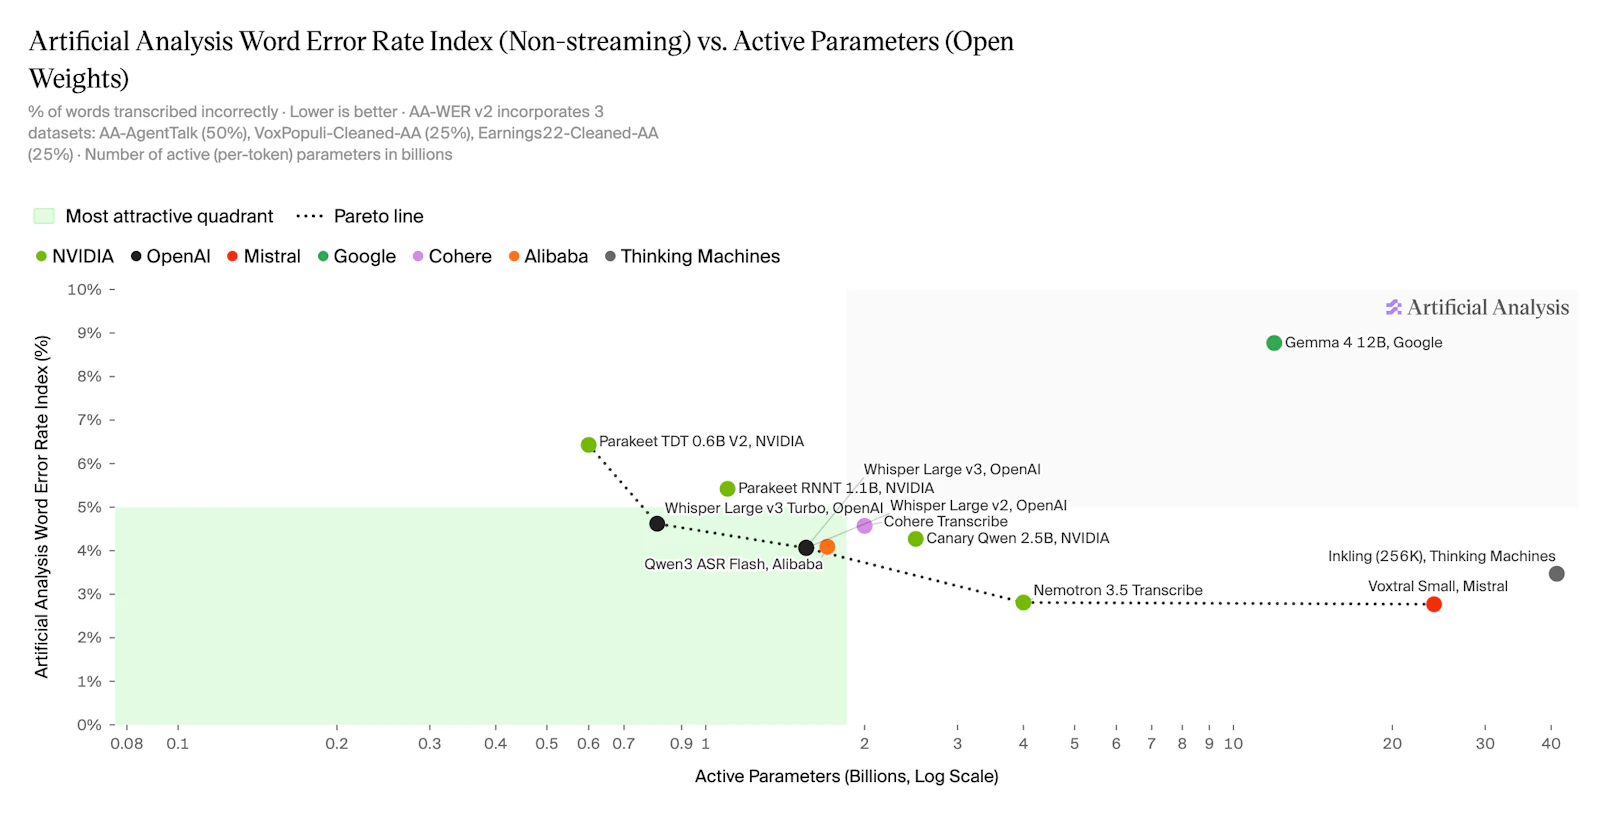
モデルカードは総パラメータ数を音声エンコーダー込みで340億、動作時に使う部分を約43億としている。商用利用にも対応し、重みと導入方法が公開されている。対象は録音済み音声で、ライブ配信をそのまま処理するストリーミングモデルではない。速度の紹介値には専用の最適化条件があるため、公開構成での性能と区別が必要だ。
業務語彙と出力形式を調整
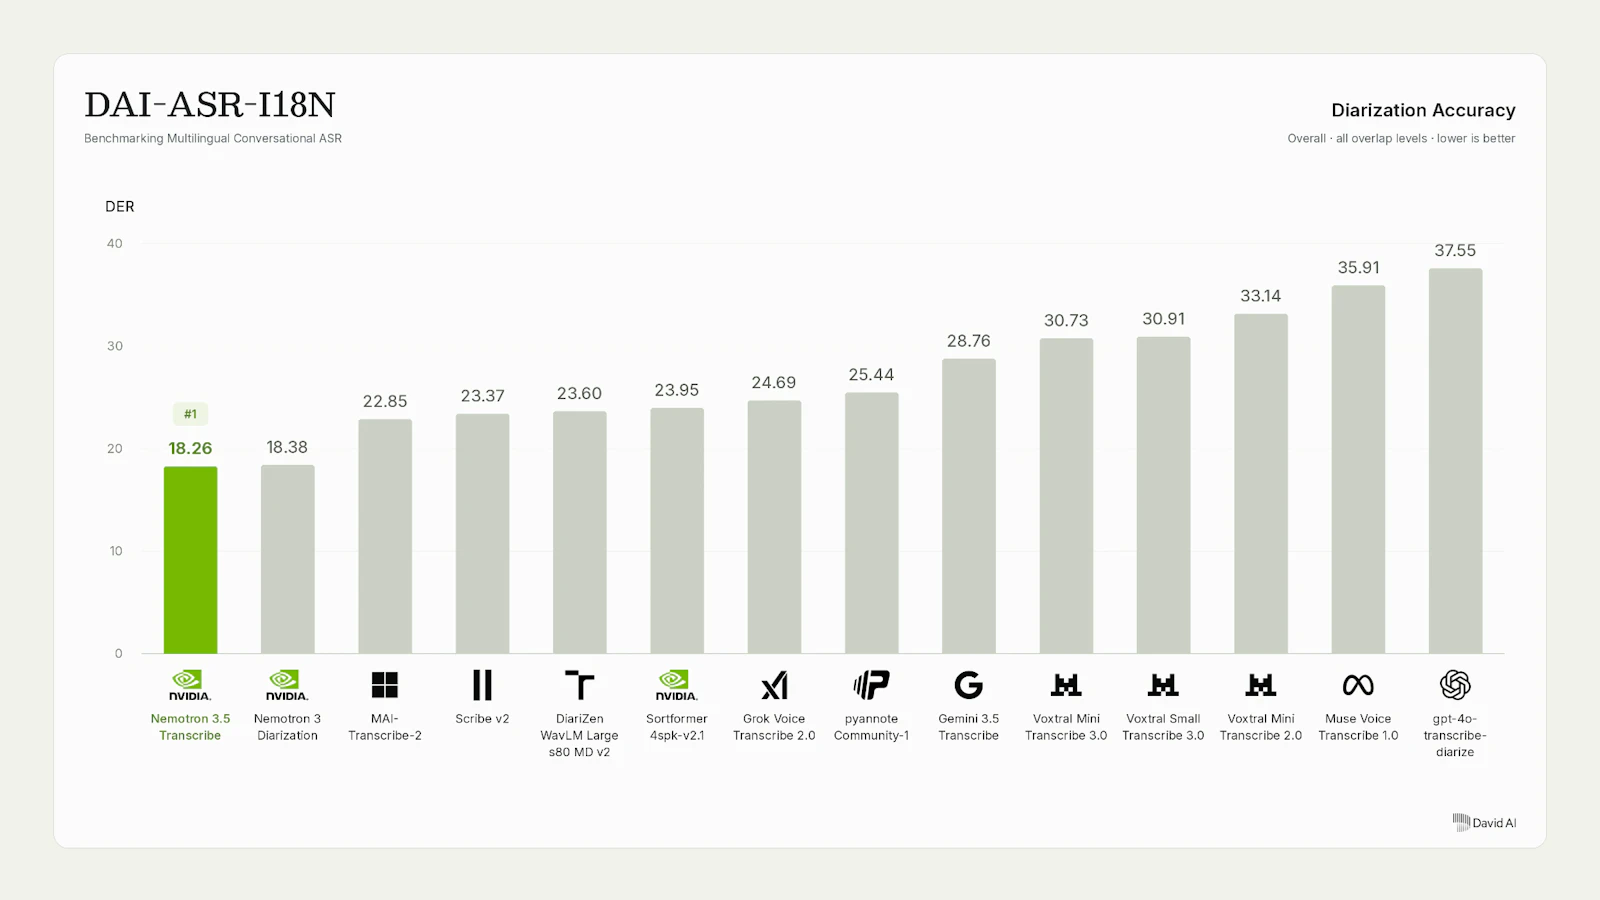
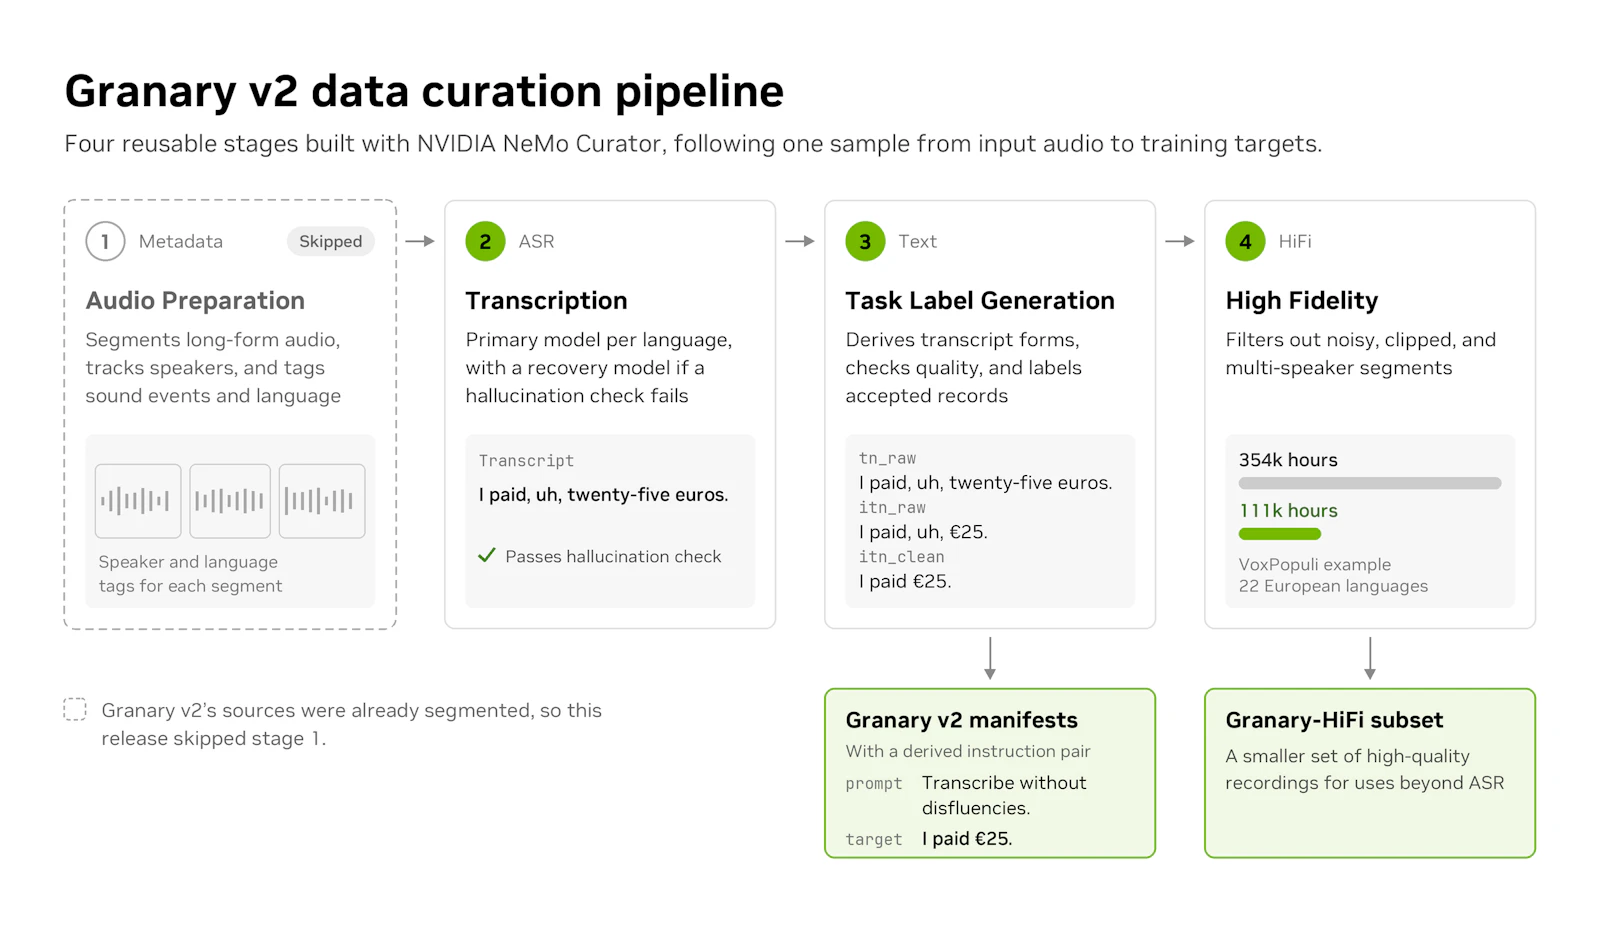
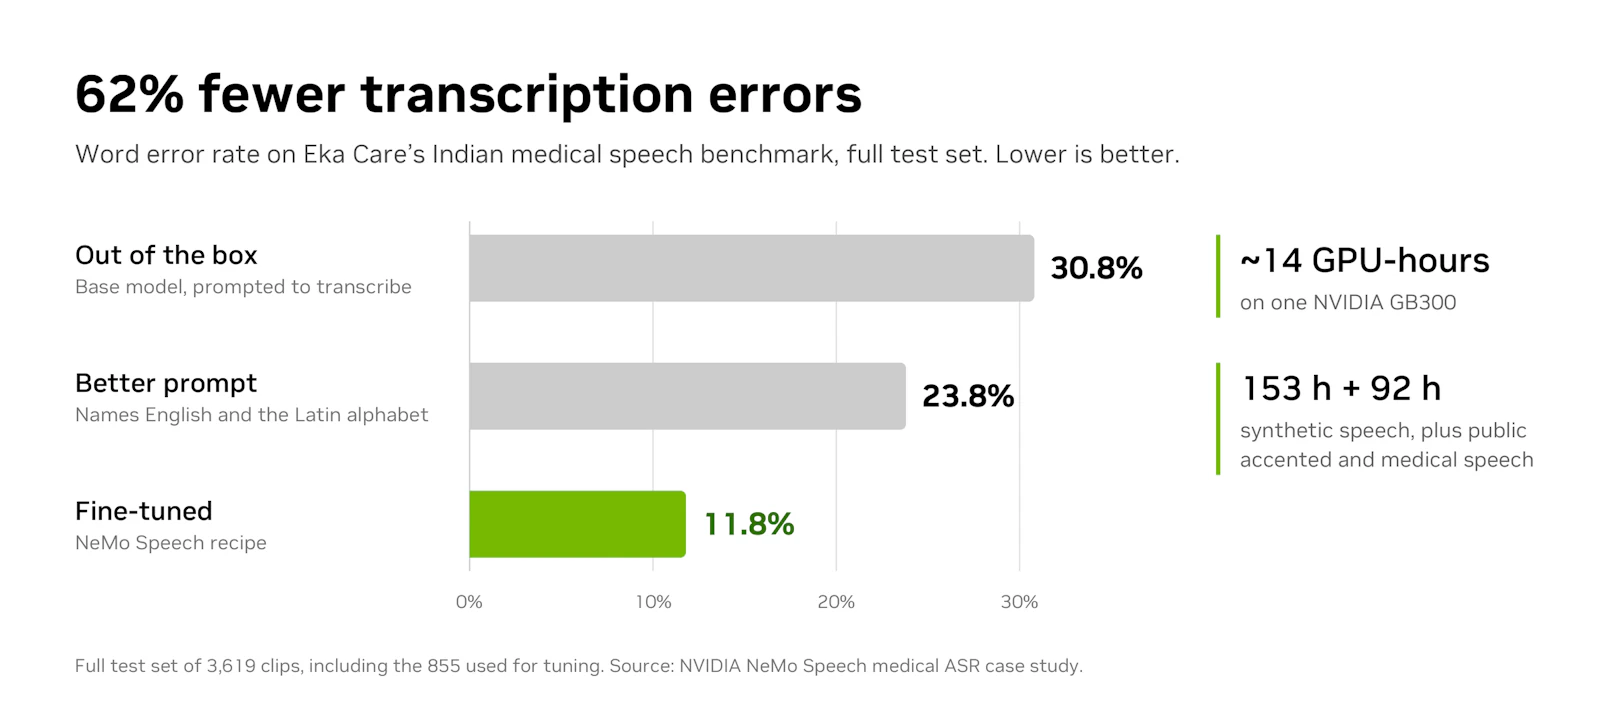
同社は、自然言語の指示による出力調整と、Granary v2やNeMoの仕組みを使う追加学習を紹介した。【実務上の考察】最初から追加学習を行うより、商品名や人名、数字の表記など、実際に困っている誤りを整理する方が評価しやすい。指示の変更だけで改善する部分と、学習データが必要な部分を分けて検討できる。
導入前の確認ポイント
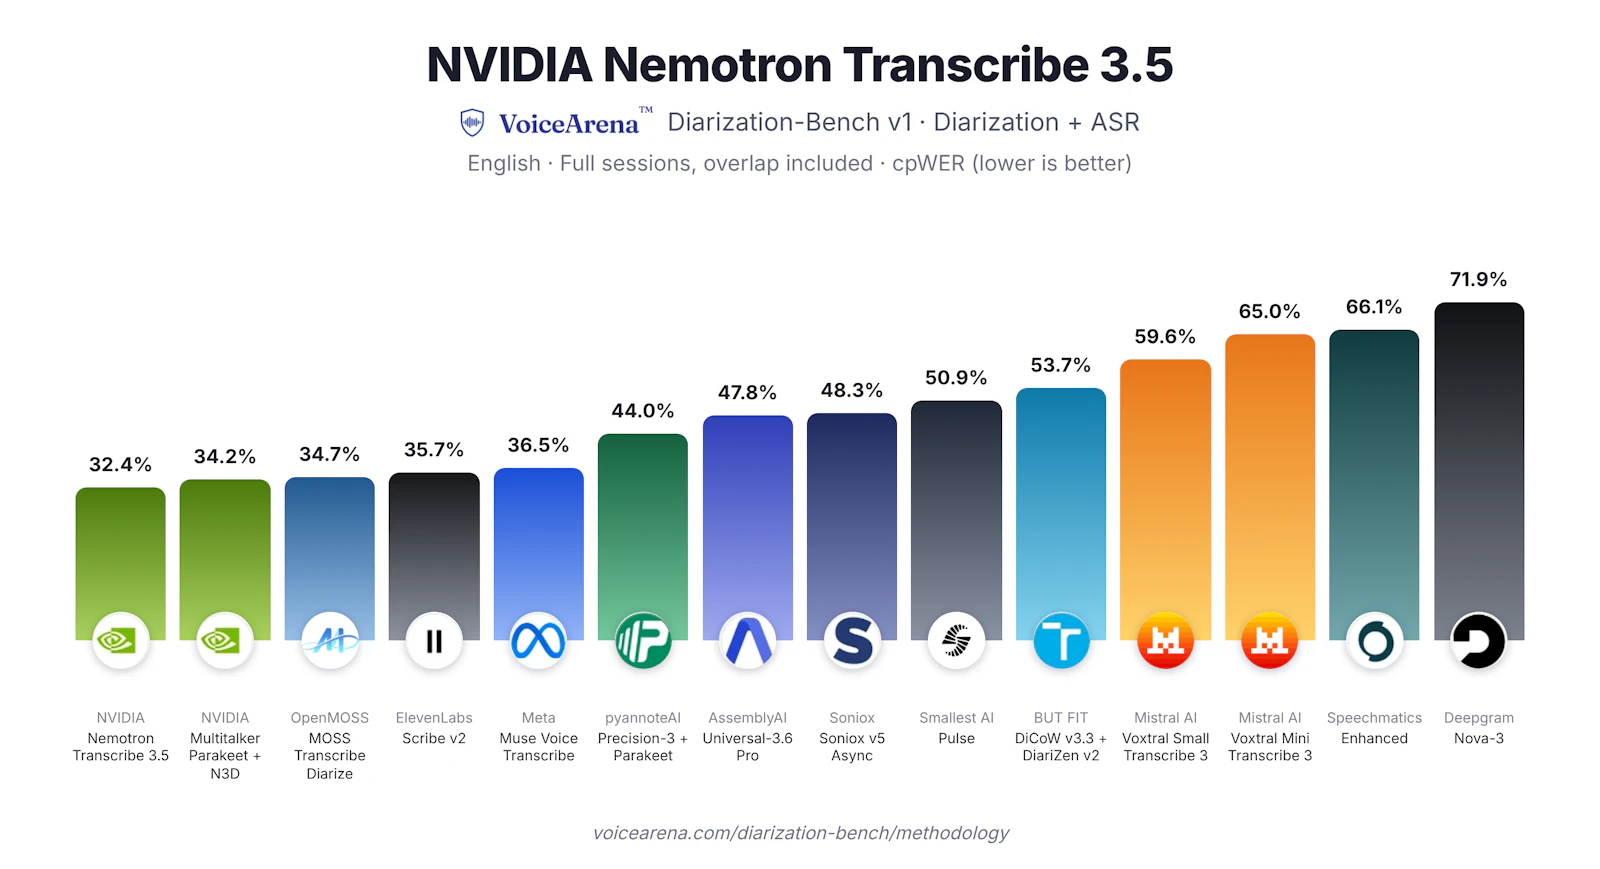
【実務上の考察】検証用の録音は、静かな会議室だけでなく、雑音、発言の重なり、電話音質など、実際に多い条件を含めたい。誤りの修正に必要な時間を比較すれば、精度指標だけでは見えない運用負荷を把握できる。翻訳や要約を後段に組み合わせる場合は、文字起こしの誤りがそのまま広がらないよう、元の音声へ戻れる仕組みも重要になる。機密性の高い録音では、検証段階から保存先と削除手順を決めておく必要がある。
企業の業務活用への示唆
【実務上の考察】会議録やコールセンターの録音では、単語全体の正解率だけでなく、金額、日付、固有名詞、発言者の取り違えが業務に与える影響を測りたい。自社環境で処理する場合も、録音の同意、アクセス権、保存期間、ログ管理は別途必要になる。まず代表的な録音で検証し、修正にかかる人の時間と計算資源の費用を合わせて比較するのが現実的だ。
一次情報
提供状況は2026年10月30日時点。機能・利用条件は公式の最新案内をご確認ください。